Qwen3.8 27B 양자화 실험: 4비트는 17GB로 원본급 성능, 1비트는 무너져요
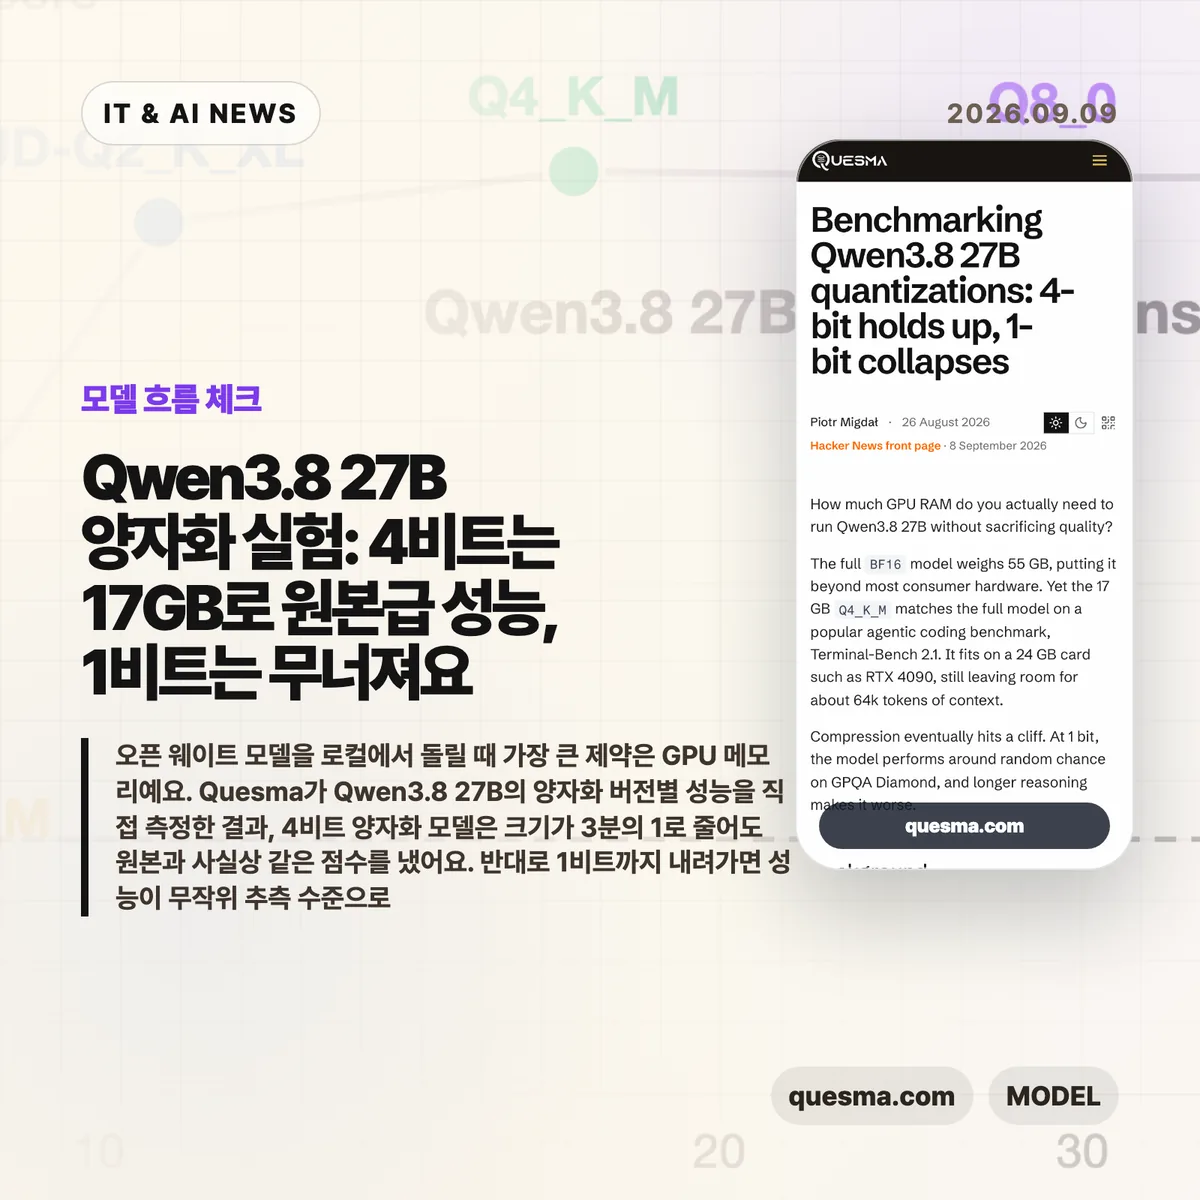
오픈 웨이트 모델을 로컬에서 돌릴 때 가장 큰 제약은 GPU 메모리예요. Quesma가 Qwen3.8 27B의 양자화 버전별 성능을 직접 측정한 결과, 4비트 양자화 모델은 크기가 3분의 1로 줄어도 원본과 사실상 같은 점수를 냈어요. 반대로 1비트까지 내려가면 성능이 무작위 추측 수준으로 떨어져요. 1
핵심 요약
| 구분 | 핵심 | 왜 볼 만한가요 |
| 모델 경량화 | 55GB BF16 원본을 4비트 Q4_K_M으로 줄이면 17GB | RTX 4090 한 장으로 64k 컨텍스트와 함께 실행 가능 |
| 벤치마크 | GPQA Diamond, IFBench, Terminal-Bench 2.1 직접 측정 | 토큰 예측 일치율이 아니라 실제 작업 해결 능력을 봄 |
| 2비트 | 지시 준수는 유지, 과학·코딩은 하락 | 같은 과제 해결에 출력 토큰 약 25% 더 소모 |
| 1비트 | 과학 문제에서 무작위 추측 수준 | 추론을 길게 돌릴수록 오히려 점수가 낮아짐 |
1. 4비트 양자화는 원본과 차이가 없어요
Qwen3.8 27B 원본(BF16)은 55GB라서 소비자용 GPU로 올리기 어려워요. Quesma는 Unsloth의 GGUF 양자화 버전 4종(8비트 29GB, 4비트 17GB, 2비트 10.7GB, 1비트 6.2GB)을 llama.cpp로 직접 돌려 비교했어요. 평가는 과학 지식(GPQA Diamond), 지시 준수(IFBench), 에이전트 코딩(Terminal-Bench 2.1) 세 가지로 했고, 실험 비용만 약 3,000달러가 들었어요. 2
결과부터 말하면 4비트 Q4_K_M(17GB)은 세 평가에서 원본과 눈에 띄는 차이가 없었어요. 특히 Terminal-Bench 2.1에서는 원본과 같은 통과율을 냈어요. 17GB면 24GB짜리 RTX 4090에 올리고도 약 64k 토큰 컨텍스트를 위한 공간이 남아요. KV 캐시를 F16으로 유지해도 32k 토큰당 약 2.3GB를 차지하는데, 이걸까지 계산해도 단일 소비자용 GPU에서 원본에 가까운 작업 성능을 얻을 수 있다는 뜻이에요. 2
측정 방식도 눈여겨볼 점이에요. 흔히 쓰는 KL 발산이나 최상위 토큰 예측 일치율은 측정하기는 쉽지만, 모델이 실제 과제를 풀 수 있는지는 알려주지 않아요. 토큰이 달라도 같은 품질의 답을 바꿔 쓴 것일 수 있고, 반대로 토큰 하나 차이가 논리 오류를 만들기도 해요. 그래서 이번 실험은 토큰 단위 비교 대신 벤치마크 점수 그 자체를 재는 방향을 택했어요. 2
왜 중요한가요
로컬 LLM 사용자에게는 실질적인 선택 기준이 돼요. "필요한 컨텍스트까지 포함해 GPU 메모리에 들어가는 가장 좋은 모델"을 고르는 게 원칙인데, 이번 측정은 대부분 작업에서 Q4_K_M이 그 답이라는 근거를 줘요. 양자화 손실은 선형이 아니라 계단식이에요. 4비트까지는 잡음 수준이고, 2비트에서 살짝 내려가다가, 1비트에서 무너져요. 그래서 "무조건 작게"보다 "어디까지 괜찮은지"를 아는 게 중요해요. 2
2비트 UD-Q2_K_XL(10.7GB)은 지시 준수에서는 원본과 같았지만 과학 문제와 코딩에서 하락했어요. 흥미로운 건 같은 코딩 과제를 풀 때도 출력 토큰을 약 25% 더 쓴다는 점이에요. 턴 수는 비슷하게 유지되는데 더 많이 적으면서 푸는 거라, 속도와 비용에서 손해를 보는 구조예요. 그래도 Terminal-Bench 2.1에서는 Opus 4.7이나 Gemini 3.1 Pro급 수준이라, 단순 작업용으로는 쓸만해요. 2
1비트는 결과가 다른 방향이에요. GPQA Diamond 점수가 무작위 추측 수준이고, 추론 강도를 높일수록 오히려 점수가 떨어져요. 토큰 예산을 전부 소진하고 빈 답을 반환하는 경우가 늘기 때문이에요. 모델 크기가 6.2GB까지 줄어도 이 영역에서는 실용성이 없다는 결론이에요. 1
한 가지 주의점도 있어요. 이번 실험에 쓰인 Unsloth v2 양자화 파일은 2026년 8월 19일 교체돼서, 실험에 사용된 정확한 파일은 더 제공되지 않아요. 재현을 원하면 이 시점 차이를 감안해야 해요. 2
참고 자료
- Qwen3.8 27B 양자화 벤치마크: 4비트는 성능 유지, 1비트는 붕괴 — GeekNews
- Benchmarking Qwen3.8 27B quantizations: 4-bit holds up, 1-bit collapses — Quesma Blog
- Hacker News 토론 — Hacker News
'IT & AI' 카테고리의 다른 글
| 애플이 첫 폴더블 아이폰을 내놨어요: 아이폰 듀오 5가지 핵심 (0) | 2026.09.10 |
|---|---|
| GPT-6 Astra 시대, 쌓아둔 에이전트 지시문을 다시 손볼 때예요 (0) | 2026.09.09 |
| 2026년, 비밀번호 관리자 바꾸기가 어려웠던 시절은 끝났어요 (0) | 2026.09.09 |
| 28년 경력 개발자가 MIT를 버리고 EUPL을 선택한 이유 (0) | 2026.09.09 |
| JavaScript 없이 게임을 돌리는 극단적인 서버 사이드 렌더링 실험 (0) | 2026.09.09 |


